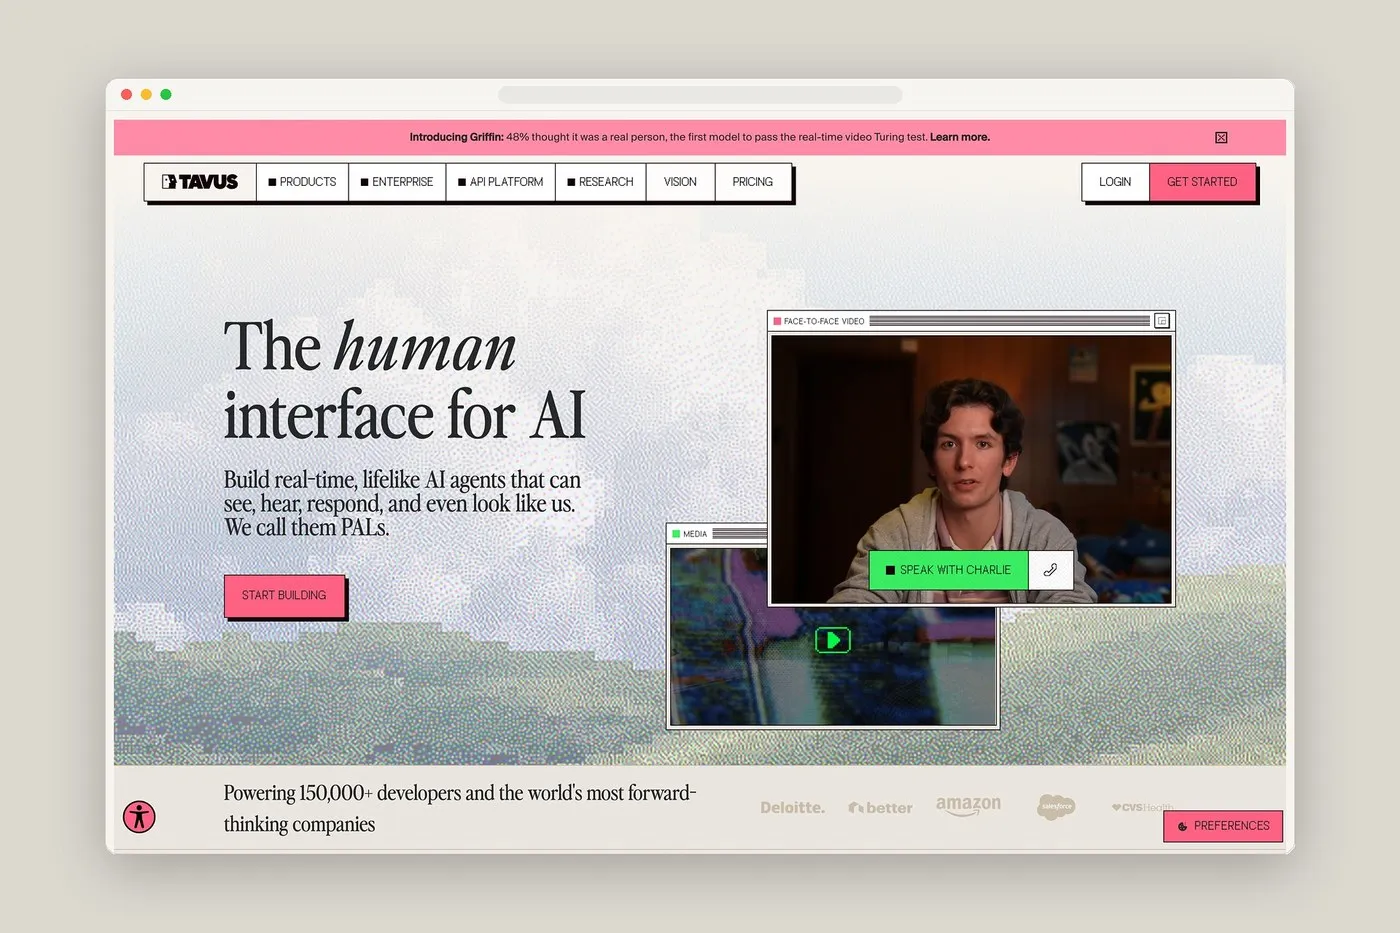
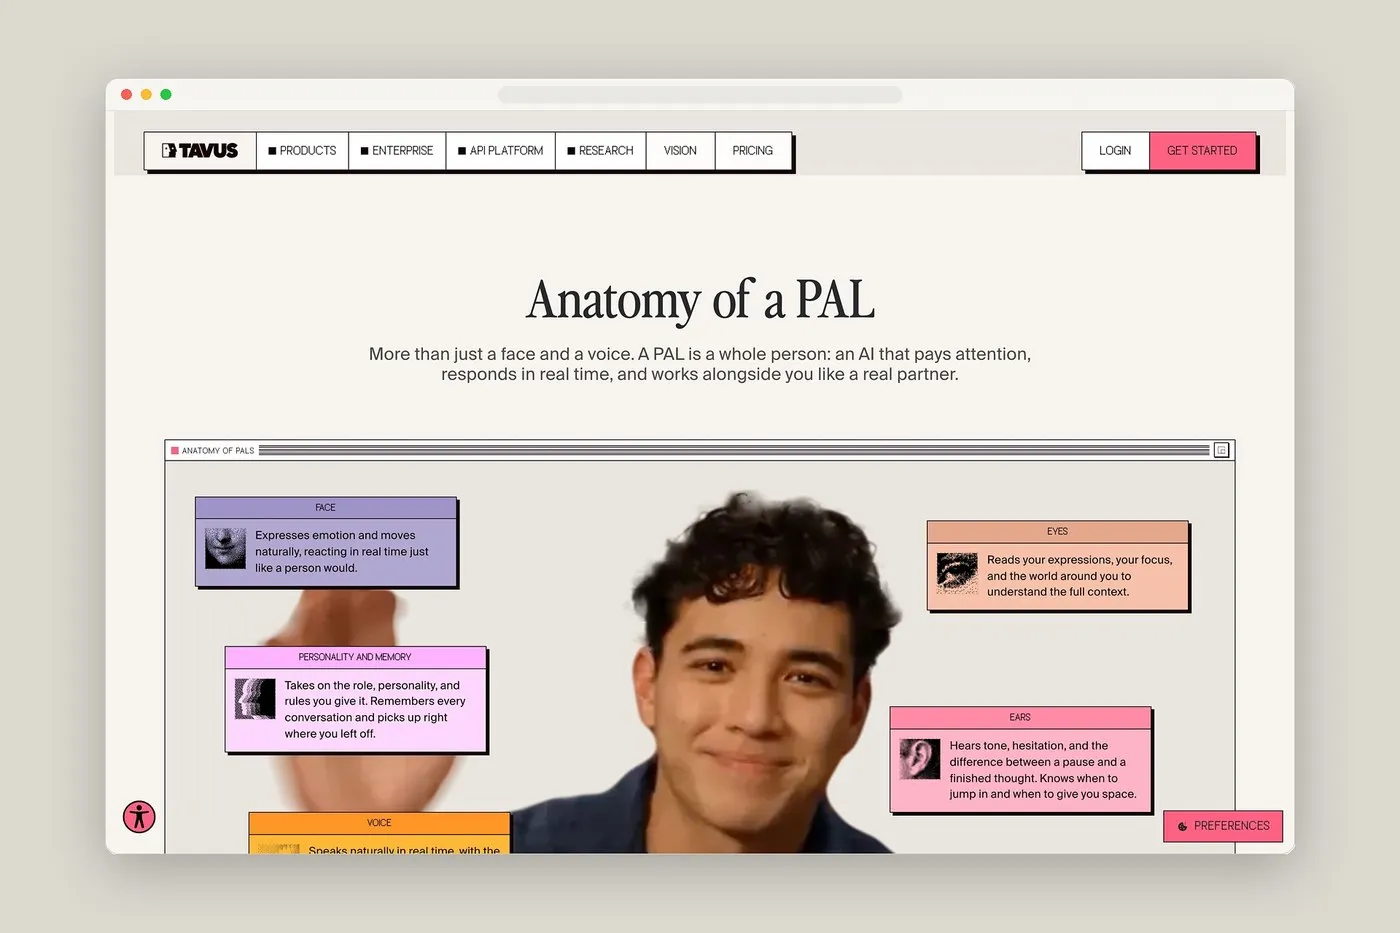
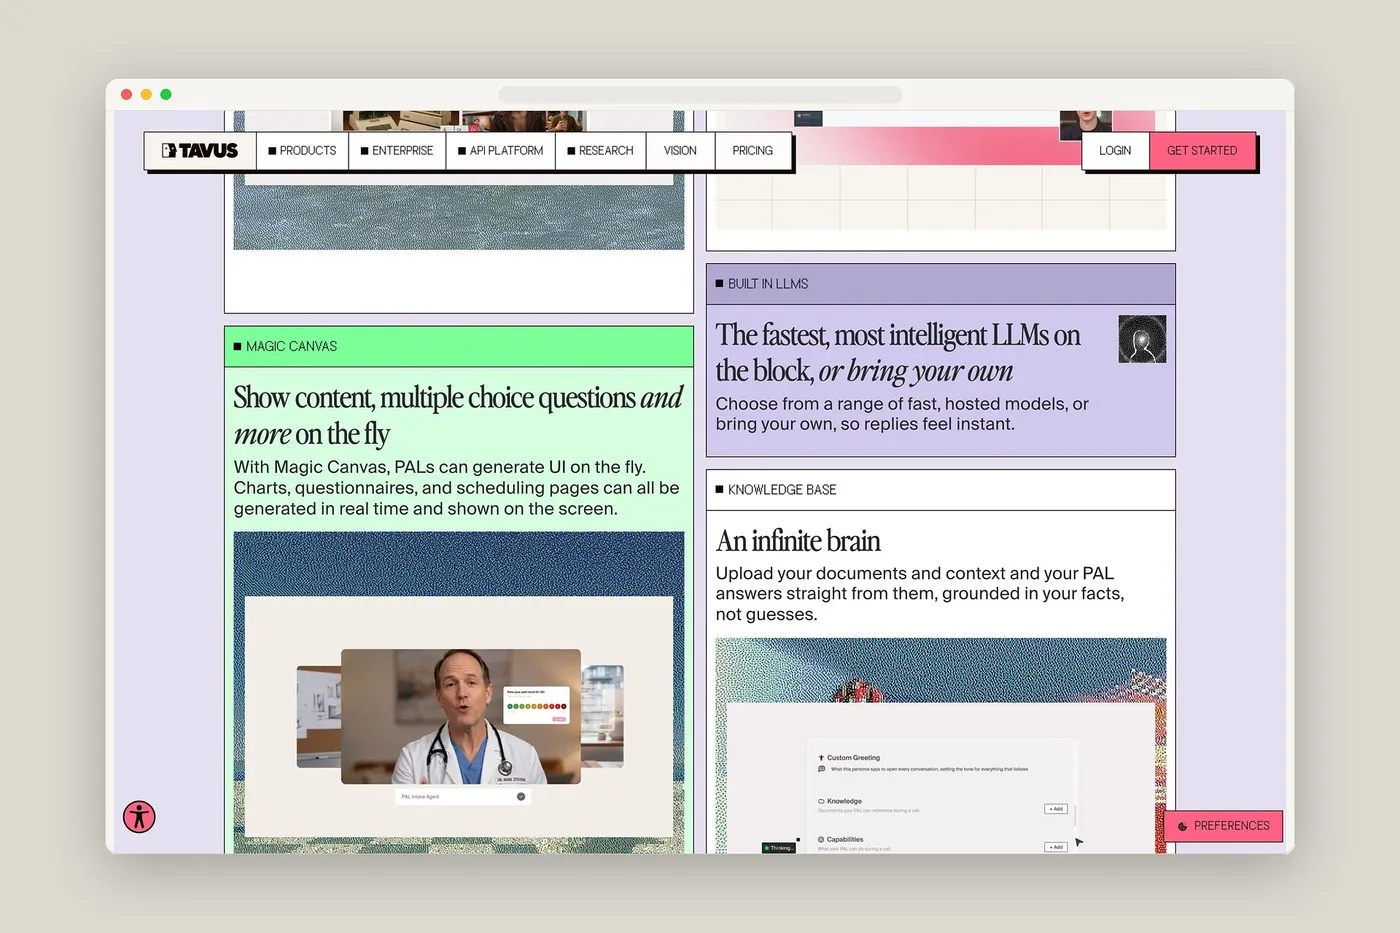
Real-Time Conversational AI Video from Tavus: A Leap Forward for Digital Interaction In the past, experimenting with conversational interfaces usually meant choosing between realism and speed. Most AI avatars ended up looking super stiff like synthetic models or suffered from awkward pauses that completely killed the connection. But Tavus is closing that gap in a big way. Live interactions feel remarkably smooth and natural. Subtle micro-expressions, responsive eye tracking, and speech-synced lip movement strip away that robotic feel to make the whole experience feel fluid and human.
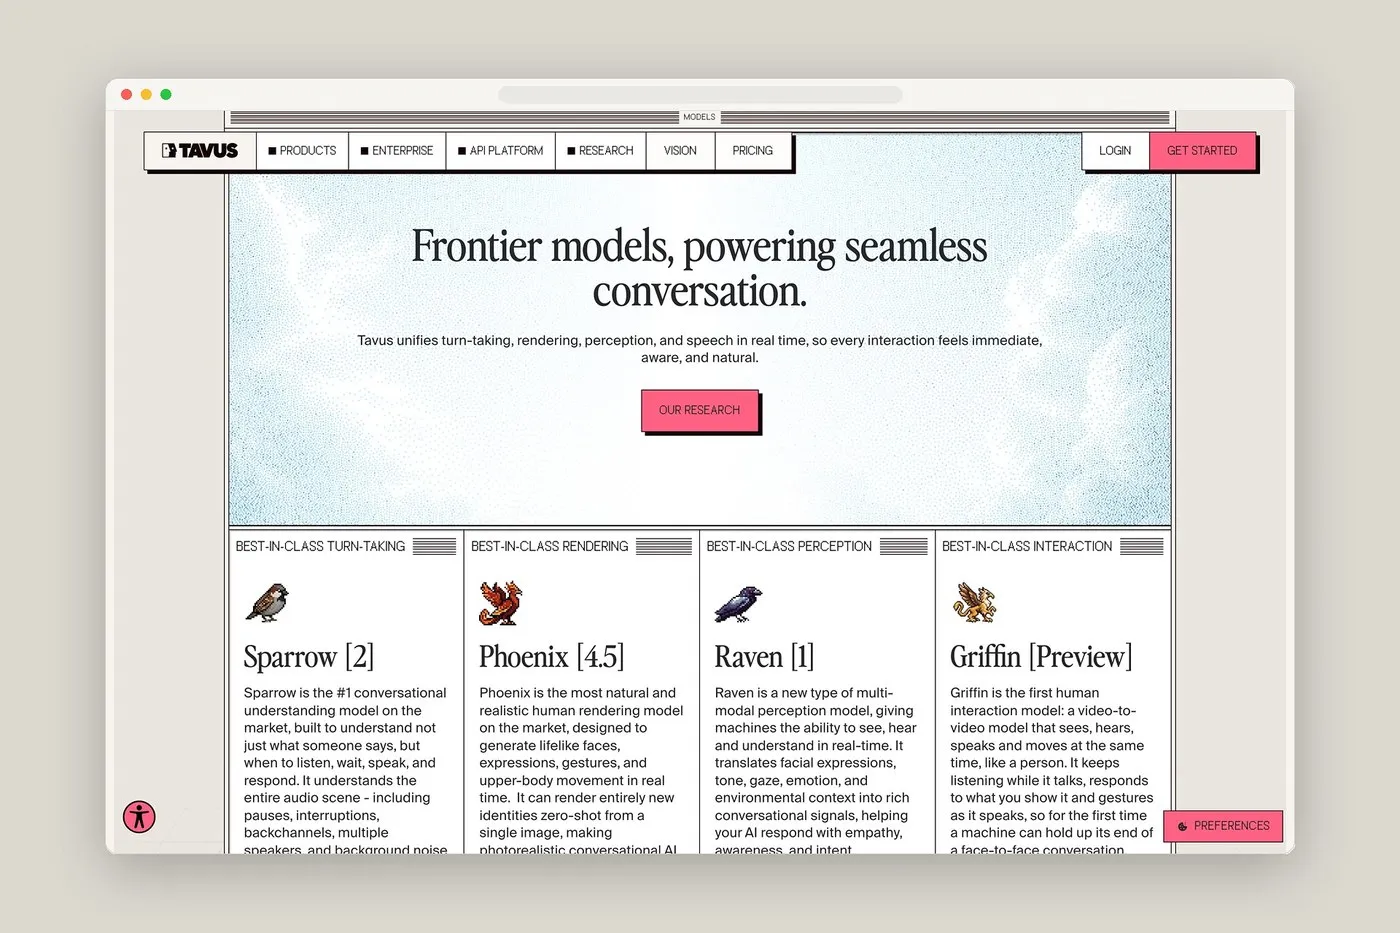
Powering this experience is Griffin—a foundational model built by Tavus specifically for real-time human-to-machine interaction. Instead of stitching together separate stages—like converting speech to text, generating a text response, and then rendering synthetic video, which builds up annoying latency—Griffin combines audio and facial motion into a tight, low-latency feedback loop. That means facial rigging handles head nods, tilts, and subtle lighting shifts effortlessly as the face moves. Even if minor stutters happen occasionally due to network fluctuations or complex commands, the underlying architecture is seriously impressive.
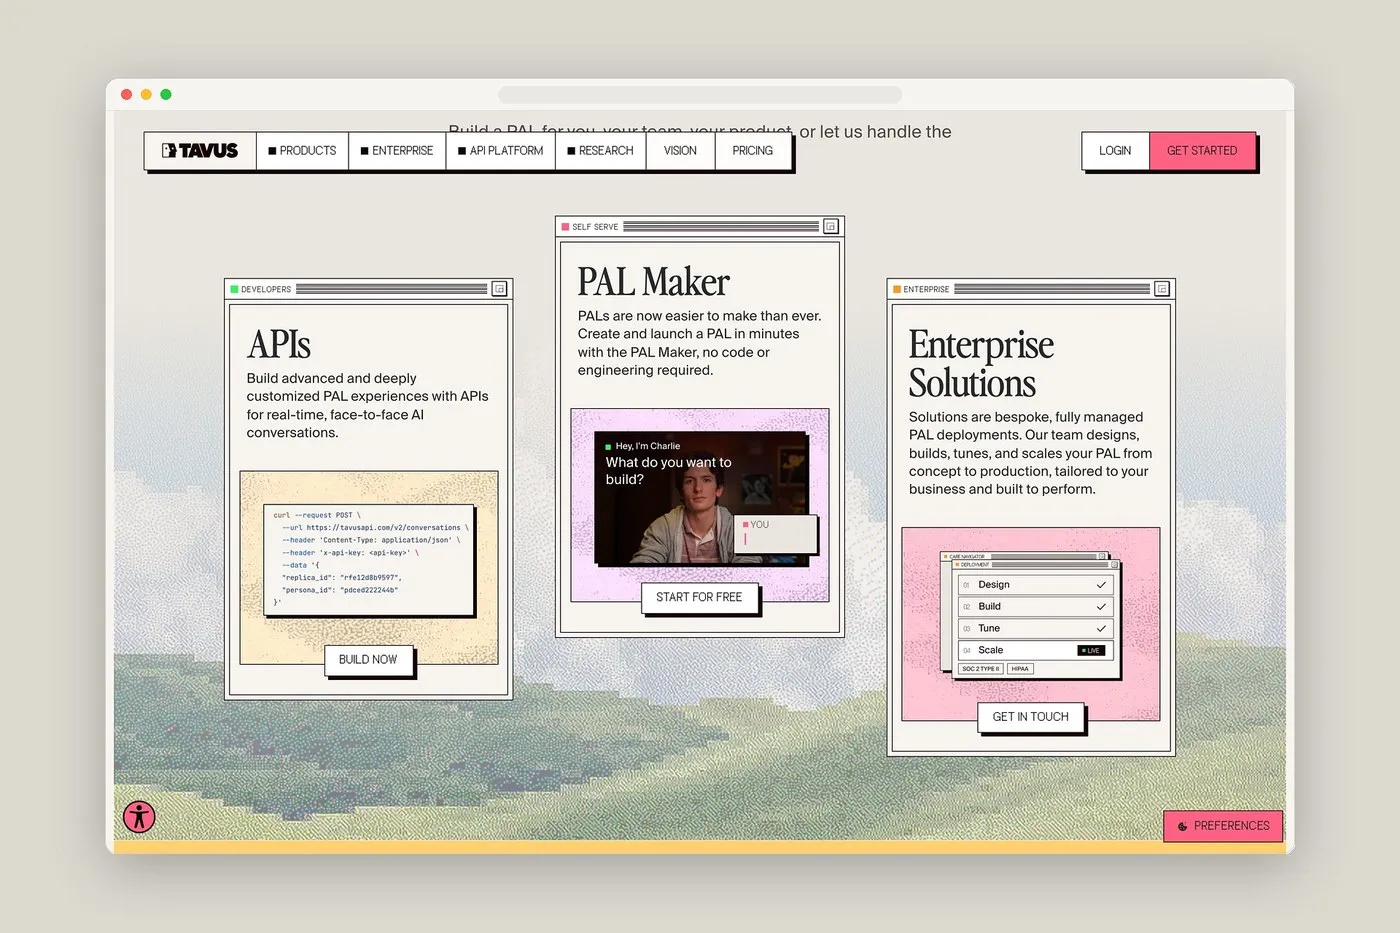
For design workflows, the real magic lies in interactive video creation and live product onboarding. Instead of spending endless hours recording static walkthrough videos that quickly go out of date, design teams can deploy virtual guides that answer user questions in real time. Everything from tech support to onboarding transforms into engaging, flexible conversations rather than clunky manual tasks. Check out the platform over at www.tavus.io/.
Video AI trò chuyện thời gian thực từ Tavus: Bước tiến mới cho trải nghiệm tương tác số
Trước đây, việc thử nghiệm các giao diện hội thoại (conversational interface) thường buộc phải đánh đổi giữa tính chân thực và tốc độ. Phần lớn avatar AI hoặc trông cứng đờ như mô hình tổng hợp, hoặc lại xuất hiện những khoảng dừng ngắc ngứ làm ngắt kết nối cảm xúc. Tuy nhiên, công nghệ từ Tavus đang cho thấy khoảng cách đó đang dần bị xóa bỏ. Khi tương tác trực tiếp, các đoạn đối thoại diễn ra tự nhiên và mượt mà. Các chi tiết như vi biểu cảm (micro-expressions), khả năng bắt nhịp ánh mắt (responsive eye tracking) cùng khẩu hình miệng đồng bộ theo ngữ điệu giọng nói giúp trải nghiệm không còn cảm giác thô cứng của máy móc.
Đứng sau trải nghiệm này là Griffin – mô hình nền tảng do Tavus phát triển chuyên phục vụ tương tác thời gian thực giữa người với máy. Thay vì ghép nối nhiều đoạn riêng biệt từ chuyển giọng nói thành văn bản, tạo văn bản phản hồi rồi mới dựng video synthesis (vốn tạo ra độ trễ cộng dồn), quy trình của Griffin kết hợp trực tiếp âm thanh và chuyển động khuôn mặt vào một vòng lặp phản hồi độ trễ thấp. Nhờ đó, hệ thống khung xương mặt (facial rigging) xử lý tự nhiên các động tác gật đầu, nghiêng đầu hay sự thay đổi ánh sáng theo chuyển động góc mặt. Dù đôi lúc vẫn có chút khựng nhẹ do biến động đường truyền mạng hoặc khi xử lý các câu lệnh phức tạp, kiến trúc mô hình bên dưới vẫn cho thấy sự hiệu quả rõ rệt.
Trong quy trình làm thiết kế, tiềm năng lớn nhất của công nghệ này nằm ở mảng tạo video tương tác và hệ thống tài liệu hướng dẫn sản phẩm trực tiếp. Thay vì tốn công quay các video walkthrough tĩnh rất nhanh bị lỗi thời, các team thiết kế có thể triển khai những hướng dẫn viên ảo trả lời thắc mắc của người dùng theo thời gian thực. Từ khâu hỗ trợ kỹ thuật cho đến hướng dẫn người dùng mới (onboarding) đều trở thành những cuộc trò chuyện linh hoạt thay vì các thao tác thủ công. Xem thêm về nền tảng này tại www.tavus.io/.